در عصر دیجیتال، هر ثانیه میلیاردها بایت اطلاعات تولید میشود. از تراکنشهای بانکی گرفته تا پستهای شبکههای اجتماعی، از سنسورهای اینترنت اشیا تا تصاویر ماهوارهای، همه و همه به اقیانوسی از دادهها تبدیل شدهاند که به آن دادههای کلان یا Big Data میگوییم. این حجم عظیم از اطلاعات نه تنها چالشی برای ذخیرهسازی و پردازش است، بلکه فرصتی بینظیر برای کسب بینشهای ارزشمند و تصمیمگیریهای هوشمندانه محسوب میشود.
دادههای کلان دیگر صرفاً یک اصطلاح فنی نیست؛ بلکه به ستون فقرات تحول دیجیتال در صنایع مختلف تبدیل شده است. از پیشبینی بیماریها در حوزه سلامت گرفته تا شخصیسازی تجربه کاربری در فضای دیجیتال، از بهینهسازی زنجیره تامین تا مبارزه با تقلبهای مالی، دادههای کلان در همه جا حضور دارند.
در این مقاله، به بررسی عمیق مفهوم دادههای کلان، معماریهای پردازش، کاربردهای پیشرفته، چالشهای امنیتی و اخلاقی، و همچنین آینده این فناوری تحولآفرین خواهیم پرداخت.
مفهوم دادههای کلان و ویژگیهای بنیادی
دادههای کلان به مجموعهای از دادهها اطلاق میشود که از نظر حجم، سرعت، تنوع و پیچیدگی به قدری بزرگ و گسترده هستند که روشهای سنتی پردازش و تحلیل دادهها قادر به مدیریت آنها نیستند. این مفهوم در اصل با سه ویژگی کلیدی شناخته میشود که به عنوان "3V" معروف هستند، اما امروزه این مدل به پنج یا حتی هفت V گسترش یافته است.
مدل 3V کلاسیک
1. حجم (Volume)
حجم دادههای کلان به شکل تصاعدی در حال رشد است. سازمانها امروزه با پتابایتها و حتی اگزابایتها داده سر و کار دارند. برای درک بهتر این مقیاس، تصور کنید که یک پتابایت معادل یک میلیون گیگابایت است. شرکتهایی مانند فیسبوک روزانه بیش از 4 پتابایت داده تولید میکنند.
این حجم عظیم نیازمند زیرساختهای ذخیرهسازی توزیعشده و سیستمهای فایل خاصی مانند HDFS (Hadoop Distributed File System) است که قادرند دادهها را بر روی صدها یا هزاران سرور توزیع کنند.
2. سرعت (Velocity)
سرعت تولید و پردازش دادهها یکی دیگر از ویژگیهای کلیدی است. دادهها دیگر به صورت دستهای (Batch) پردازش نمیشوند، بلکه به صورت جریانی و آنی (Real-time) تولید و پردازش میشوند. برای مثال، سیستمهای تشخیص تقلب بانکی باید در کمتر از چند میلیثانیه تراکنشها را تحلیل کنند.
پلتفرمهایی مانند Apache Kafka و Apache Flink برای پردازش جریانی دادهها طراحی شدهاند و میتوانند میلیونها رویداد را در ثانیه پردازش کنند.
3. تنوع (Variety)
دادههای کلان در قالبهای مختلفی وجود دارند:
- دادههای ساختاریافته: جداول پایگاه داده رابطهای، فایلهای CSV
- دادههای نیمهساختاریافته: JSON، XML، لاگهای سرور
- دادههای غیرساختاریافته: متن، تصویر، ویدئو، صدا، پستهای شبکههای اجتماعی
تنوع دادهها چالشهای خاص خود را دارد. برای مثال، تحلیل احساسات در متنهای فارسی نیاز به تکنیکهای
پردازش زبان طبیعی پیشرفته دارد، در حالی که تحلیل تصاویر پزشکی نیازمند
یادگیری عمیق و شبکههای عصبی کانولوشنال است.
ویژگیهای تکمیلی (V های اضافی)
4. صحت و اعتبار (Veracity)
یکی از بزرگترین چالشها در کار با دادههای کلان، کیفیت و قابلیت اعتماد آنهاست. دادهها میتوانند حاوی نویز، اطلاعات ناقص، دادههای تکراری یا حتی اطلاعات گمراهکننده باشند. برای مثال، دادههای سنسورهای IoT ممکن است به دلیل خرابی سختافزاری مقادیر نادرستی تولید کنند.
تکنیکهای تمیزسازی داده (Data Cleaning)، شناسایی ناهنجاری و اعتبارسنجی از اهمیت بالایی برخوردارند. الگوریتمهایی مانند
Isolation Forest برای تشخیص دادههای پرت و ناهنجار به کار میروند.
5. ارزش (Value)
در نهایت، هدف از جمعآوری و پردازش دادههای کلان، استخراج ارزش و بینش از آنهاست. داده خام به تنهایی ارزش ندارد؛ باید از طریق تحلیل و
یادگیری ماشین به اطلاعات قابل اقدام تبدیل شود.
6. تغییرپذیری (Variability)
معنا و زمینه دادهها میتواند متغیر باشد. برای مثال، واژه "بانک" میتواند به مؤسسه مالی یا کنار رودخانه اشاره کند. این تغییرپذیری معنایی چالشهای خاصی در تحلیل متن و زبان طبیعی ایجاد میکند.
7. مرئیسازی (Visualization)
توانایی نمایش بصری دادههای کلان به شکلی قابل فهم برای تصمیمگیرندگان اهمیت حیاتی دارد. ابزارهای مرئیسازی مانند Tableau، Power BI و کتابخانههای پایتون مانند Matplotlib و Plotly به این منظور استفاده میشوند.
معماری و ابزارهای پردازش دادههای کلان
برای کار با دادههای کلان، نیاز به معماریها و فناوریهای خاصی داریم که بتوانند چالشهای مقیاس، سرعت و تنوع را مدیریت کنند.
اکوسیستم Hadoop
Apache Hadoop یکی از پایهگذاران اصلی انقلاب دادههای کلان است. این پلتفرم متنباز بر اساس دو مفهوم اصلی کار میکند:
- HDFS (Hadoop Distributed File System): سیستم فایل توزیعشده که دادهها را به بلوکهای کوچک تقسیم کرده و بر روی چندین نود ذخیره میکند. این معماری هم مقیاسپذیری و هم تحملپذیری خطا را فراهم میکند.
- MapReduce: مدل برنامهنویسی برای پردازش موازی دادهها. این مدل کار را به دو فاز تقسیم میکند: Map (نگاشت) که دادهها را پردازش و تبدیل میکند، و Reduce (کاهش) که نتایج را جمعآوری و تجمیع میکند.
اکوسیستم Hadoop شامل ابزارهای بسیار دیگری مانند Hive (پرسوجوی SQL روی Hadoop)، Pig (زبان برنامهنویسی سطح بالا)، HBase (پایگاه داده NoSQL) و Sqoop (انتقال داده بین Hadoop و پایگاههای رابطهای) است.
Apache Spark: پردازش سریع و یکپارچه
Apache Spark به عنوان جانشین نسل بعدی MapReduce شناخته میشود. این موتور پردازش چند برابر سریعتر از MapReduce عمل میکند زیرا:
- از پردازش در حافظه (In-Memory Processing) استفاده میکند
- یک مدل برنامهنویسی یکپارچه برای پردازش دستهای و جریانی ارائه میدهد
- کتابخانههای غنی برای یادگیری ماشین (MLlib)، پردازش گراف (GraphX) و SQL دارد
Spark امروزه به یکی از محبوبترین ابزارها برای پردازش دادههای کلان تبدیل شده است و در کنار
TensorFlow و
PyTorch برای آموزش مدلهای یادگیری ماشین مقیاس بزرگ استفاده میشود.
پایگاههای داده NoSQL
پایگاههای داده سنتی رابطهای (SQL) برای کار با دادههای ساختاریافته و تراکنشهای ACID طراحی شدهاند. اما برای دادههای کلان با تنوع و مقیاس بالا، نیاز به مدلهای جدید داریم:
1. پایگاههای داده Key-Value
سادهترین مدل NoSQL که هر داده را با یک کلید منحصر به فرد ذخیره میکند. مثالها: Redis، DynamoDB
2. پایگاههای داده Document-Oriented
دادهها را به صورت اسناد JSON یا BSON ذخیره میکنند. مثالها: MongoDB، CouchDB
3. پایگاههای داده Column-Family
برای کوئریهای تحلیلی بر روی ستونهای خاص بهینه شدهاند. مثالها: Apache Cassandra، HBase
4. پایگاههای داده Graph
برای ذخیره و کوئری روابط پیچیده بین دادهها طراحی شدهاند. مثالها: Neo4j، Amazon Neptune
پلتفرمهای پردازش جریانی
برای سناریوهایی که نیاز به پردازش آنی دارند، ابزارهای مخصوصی وجود دارند:
- Apache Kafka: پلتفرم توزیعشده برای جریانهای رویداد که قادر است میلیونها پیام را در ثانیه مدیریت کند
- Apache Flink: موتور پردازش جریانی با تضمین دقیقاً یکبار (Exactly-Once Processing)
- Apache Storm: سیستم پردازش جریانی در زمان واقعی
محاسبات ابری و دادههای کلان
پلتفرمهای ابری نقش حیاتی در دموکراتیزه کردن دسترسی به ابزارهای دادههای کلان دارند:
- Amazon Web Services (AWS): EMR، Redshift، Kinesis
- Google Cloud Platform: BigQuery، Dataflow، Pub/Sub
- Microsoft Azure: HDInsight، Synapse Analytics، Stream Analytics
این سرویسها مقیاسپذیری خودکار، مدیریت سادهتر و مدل قیمتگذاری پرداخت به ازای استفاده را ارائه میدهند. علاوه بر این،
ابزارهای هوش مصنوعی ابر گوگل امکانات پیشرفتهای برای تحلیل دادهها و ساخت مدلهای یادگیری ماشین فراهم میکنند.
کاربردهای پیشرفته دادههای کلان در صنایع مختلف
دادههای کلان در تقریباً هر صنعتی کاربرد دارند و به شکلهای گوناگون ارزشآفرینی میکنند.
بهداشت و درمان: پزشکی شخصیسازی شده
صنعت سلامت یکی از بزرگترین بهرهبرندگان از دادههای کلان است:
تشخیص پیشرفته بیماریها
هوش مصنوعی در تشخیص و درمان از تحلیل تصاویر پزشکی، نتایج آزمایشها و سوابق بیماران برای تشخیص زودهنگام بیماریها استفاده میکند. سیستمهای یادگیری عمیق میتوانند سرطان پوست را با دقت بالاتری نسبت به متخصصان انسانی تشخیص دهند.
ژنومیکس و پزشکی دقیق
تحلیل توالی ژنوم انسان حجم عظیمی از داده تولید میکند. با تحلیل این دادهها در کنار سایر اطلاعات بالینی، میتوان درمانهای شخصیسازی شده طراحی کرد که برای ژنتیک خاص هر بیمار بهینه شده است.
پیشبینی شیوع بیماریها
با تحلیل دادههای جمعیتی، جغرافیایی، اقلیمی و شبکههای اجتماعی، میتوان شیوع بیماریهای همهگیر را پیشبینی کرد. این روش در دوران همهگیری COVID-19 اهمیت حیاتی پیدا کرد.
کشف داروهای جدید
هوش مصنوعی در کشف دارو با تحلیل میلیونها ترکیب شیمیایی و شبیهسازی تعاملات مولکولی، فرآیند توسعه دارو را که معمولاً دهها سال و میلیاردها دلار هزینه دارد، به شکل چشمگیری تسریع میکند.
خدمات مالی: امنیت و بهینهسازی
تشخیص تقلب در زمان واقعی
سیستمهای تشخیص تقلب با تحلیل میلیونها تراکنش در ثانیه، الگوهای غیرعادی را شناسایی میکنند. این سیستمها از
یادگیری ماشین در خدمات مشتریان و تکنیکهای شناسایی ناهنجاری استفاده میکنند.
مدیریت ریسک اعتباری
بانکها با تحلیل تاریخچه مالی، رفتار تراکنشی، دادههای شبکههای اجتماعی و صدها متغیر دیگر، مدلهای دقیقتری برای ارزیابی ریسک وامگیرندگان میسازند.
معاملات الگوریتمی
شخصیسازی خدمات بانکی
با تحلیل رفتار مشتریان، بانکها میتوانند محصولات مالی مناسب را در زمان مناسب پیشنهاد دهند و تجربه کاربری بهتری ارائه کنند.
بازاریابی دیجیتال: شخصیسازی تجربه
تحلیل مشتری 360 درجه
با ترکیب دادهها از منابع مختلف (وبسایت، اپلیکیشن موبایل، شبکههای اجتماعی، فروشگاههای فیزیکی)، یک تصویر کامل از هر مشتری ایجاد میشود.
هوش مصنوعی در بازاریابی دیجیتال از این بینش برای شخصیسازی استفاده میکند.
پیشبینی ترک خدمت (Churn Prediction)
با شناسایی مشتریانی که احتمال ترک سرویس دارند، شرکتها میتوانند اقدامات پیشگیرانه انجام دهند. مدلهای یادگیری ماشین با تحلیل الگوهای رفتاری میتوانند این پیشبینی را با دقت بالایی انجام دهند.
بهینهسازی قیمتگذاری پویا
شرکتهای حملونقل، هتلها و فروشگاههای آنلاین از دادههای کلان برای تنظیم قیمتها به صورت پویا بر اساس تقاضا، رقابت و عوامل دیگر استفاده میکنند.
بهینهسازی هوش مصنوعی این فرآیند را خودکار میکند.
تحلیل احساسات و شنیدن اجتماعی
تحلیل نظرات و احساسات کاربران در شبکههای اجتماعی به برندها کمک میکند تا به سرعت به بحرانها واکنش نشان دهند و فرصتها را شناسایی کنند.
حملونقل و لجستیک هوشمند
بهینهسازی مسیر و زنجیره تامین
شرکتهای لجستیک با تحلیل دادههای ترافیک، آبوهوا، مصرف سوخت و محدودیتهای زمانی، بهینهترین مسیرها را محاسبه میکنند. این بهینهسازی میتواند صدها میلیون دلار در هزینههای سوخت و زمان صرفهجویی کند.
نگهداری پیشبینانه
تحلیل دادههای سنسورها در هواپیماها، قطارها و کامیونها میتواند خرابیهای احتمالی را پیش از وقوع پیشبینی کند، از توقفهای غیرمنتظره جلوگیری کند و ایمنی را افزایش دهد.
خودروهای خودران
هوش مصنوعی در صنعت خودرو با پردازش دادههای عظیم از دوربینها، لیدارها، رادارها و سنسورهای دیگر، تصمیمگیریهای لحظهای برای رانندگی ایمن را امکانپذیر میکند.
کشاورزی هوشمند
هوش مصنوعی در کشاورزی هوشمند با تحلیل دادههای ماهوارهای، سنسورهای خاک، الگوهای آبوهوایی و تصاویر پهپاد، کشاورزان را در بهینهسازی مصرف آب، کود و سموم دفع آفات یاری میکند. این رویکرد هم عملکرد را افزایش میدهد و هم تأثیرات زیستمحیطی را کاهش میدهد.
انرژی و محیط زیست
پیشبینی تقاضای انرژی
شرکتهای برق با تحلیل دادههای مصرف تاریخی، الگوهای آبوهوایی و رویدادهای خاص، تقاضای انرژی را پیشبینی میکنند و تولید را بهینه میسازند.
مدیریت شبکههای هوشمند
Smart Grid ها از دادههای کلان برای بهینهسازی توزیع انرژی، ادغام منابع تجدیدپذیر و کاهش اتلاف استفاده میکنند.
نظارت بر تغییرات اقلیمی
تحلیل دادههای ماهوارهای، اقیانوسی، جوی و زمینی برای مدلسازی تغییرات اقلیمی، پیشبینی بلایای طبیعی و مدیریت منابع طبیعی استفاده میشود.
شهرهای هوشمند
نقش هوش مصنوعی در توسعه شهرهای هوشمند شامل مدیریت ترافیک، بهینهسازی مصرف انرژی، نظارت بر امنیت عمومی، مدیریت پسماند و ارائه خدمات شهری بهتر است. تحلیل دادههای جمعآوری شده از سنسورها، دوربینها و دستگاههای
IoT به مدیران شهری کمک میکند تصمیمات آگاهانهتری بگیرند.
امنیت سایبری
تأثیر هوش مصنوعی بر سیستمهای امنیت سایبری عمیق است. سیستمهای امنیتی مدرن با تحلیل ترافیک شبکه، رفتار کاربران و الگوهای حملات، تهدیدات جدید را شناسایی میکنند. تکنیکهای یادگیری ماشین میتوانند حملات zero-day و تهدیدات پیشرفته پایدار (APT) را کشف کنند.
چالشها و مسائل بحرانی در دادههای کلان
با تمام مزایای دادههای کلان، چالشها و نگرانیهای جدی نیز وجود دارند که باید به آنها پرداخت.
حریم خصوصی و امنیت داده
نقض حریم خصوصی
یکی از بزرگترین نگرانیها در دنیای دادههای کلان، حفظ حریم خصوصی افراد است. شرکتها اطلاعات شخصی عظیمی از کاربران جمعآوری میکنند که در صورت نشت یا سوءاستفاده، میتواند پیامدهای فاجعهباری داشته باشد. رسواییهایی مانند Cambridge Analytica نشان داد که دادههای شخصی چگونه میتوانند برای دستکاری افکار عمومی استفاده شوند.
امنیت و نشت داده
نشت دادهها هزینههای مالی و اعتباری سنگینی برای سازمانها دارد. با افزایش حجم دادهها، سطح حمله نیز گستردهتر میشود.
توهم حریم خصوصی در عصر هوش مصنوعی به این موضوع میپردازد که چگونه در عصر دیجیتال، حفظ حریم خصوصی واقعی دشوارتر شده است.
تهدیدهای امنیتی جدید
تزریق پرامپت و حملات مخصوص سیستمهای هوش مصنوعی، تهدیدهای نوینی هستند که با رشد استفاده از دادههای کلان در مدلهای زبانی بزرگ ظاهر شدهاند.
قوانین و مقررات
مقررات GDPR در اروپا، CCPA در کالیفرنیا و قوانین مشابه در سایر نقاط جهان، محدودیتهای سختگیرانهای بر جمعآوری، ذخیرهسازی و استفاده از دادههای شخصی وضع کردهاند. شرکتها باید هزینههای سنگینی برای تطابق با این قوانین متحمل شوند.
مسائل اخلاقی و سوگیری
سوگیری در داده و الگوریتمها
دادههای کلان اغلب منعکسکننده سوگیریهای موجود در جامعه هستند. اگر دادههای آموزشی حاوی تبعیض باشند، مدلهای یادگیری ماشین نیز این تبعیض را تقویت میکنند. برای مثال، سیستمهای تشخیص چهره دقت کمتری در شناسایی افراد با پوست تیره دارند.
شفافیت و تفسیرپذیری
بسیاری از مدلهای یادگیری عمیق به عنوان "جعبه سیاه" عمل میکنند و درک نحوه تصمیمگیری آنها دشوار است.
هوش مصنوعی قابل تفسیر تلاش میکند تا این مدلها را شفافتر کند، که در حوزههای حساس مانند سلامت و قضاوت قانونی حیاتی است.
تمرکز قدرت
شرکتهای بزرگ فناوری که به حجم عظیمی از داده دسترسی دارند، قدرت اقتصادی و سیاسی عظیمی به دست میآورند. این تمرکز قدرت میتواند به انحصار منجر شود و نوآوری را محدود کند.
چالشهای فنی
کیفیت و صحت داده
دادههای کلان اغلب نویزی، ناقص، تکراری یا ناهماهنگ هستند. تمیزسازی و اعتبارسنجی این دادهها میتواند تا ۸۰٪ از زمان یک پروژه تحلیل داده را مصرف کند.
یکپارچهسازی داده
دادهها از منابع مختلف با فرمتها، استانداردها و ساختارهای متفاوت جمعآوری میشوند. یکپارچهسازی این دادهها برای ایجاد یک دید واحد چالشبرانگیز است.
مقیاسپذیری
با رشد تصاعدی دادهها، زیرساختها باید قادر به مقیاسپذیری افقی و عمودی باشند. این نیازمند معماریهای پیچیده و هزینههای قابل توجه است.
تأخیر و پردازش واقعی
در بسیاری از کاربردها مانند تشخیص تقلب یا خودروهای خودران، پردازش باید در میلیثانیه انجام شود.
هوش مصنوعی لبهای (Edge AI) با پردازش محلی دادهها، این تأخیر را کاهش میدهد.
هزینههای ذخیرهسازی و پردازش
با وجود کاهش هزینههای ذخیرهسازی، مدیریت پتابایتها داده همچنان هزینهبر است. علاوه بر این، پردازش این دادهها نیازمند قدرت محاسباتی قابل توجهی است.
کمبود مهارت و تخصص
تحلیل دادههای کلان نیازمند تخصص در حوزههای مختلف است: برنامهنویسی (
پایتون)، آمار، یادگیری ماشین، معماری داده و درک کسبوکار. کمبود متخصصان با این ترکیب مهارتها یکی از محدودیتهای اصلی پذیرش گسترده تحلیل دادههای کلان است.
رویکردها و بهترین شیوههای کار با دادههای کلان
برای استفاده مؤثر از دادههای کلان، شیوهها و رویکردهای خاصی باید اتخاذ شوند.
معماری Data Lake و Data Warehouse
Data Warehouse: مخزن ساختاریافته برای دادههای تاریخی که برای کوئریهای تحلیلی بهینه شده است. معمولاً از schema-on-write استفاده میکند.
Data Lake: مخزن متمرکز برای ذخیرهسازی تمام دادههای ساختاریافته و غیرساختاریافته در مقیاس بزرگ با استفاده از schema-on-read. این رویکرد انعطاف بیشتری برای تحلیلهای متنوع فراهم میکند.
Data Lakehouse: ترکیبی از مزایای هر دو رویکرد که ساختار و قابلیتهای مدیریت Data Warehouse را با انعطاف و مقیاسپذیری Data Lake ترکیب میکند.
خط لوله داده (Data Pipeline)
یک خط لوله داده مراحل استخراج، تبدیل و بارگذاری (ETL یا ELT) دادهها را خودکار میکند:
- Extract: استخراج داده از منابع مختلف
- Transform: تمیزسازی، غنیسازی و تبدیل داده
- Load: بارگذاری داده به سیستمهای ذخیرهسازی نهایی
ابزارهایی مانند Apache Airflow، Luigi و Prefect برای مدیریت و زمانبندی خطوط لوله پیچیده استفاده میشوند.
حاکمیت داده (Data Governance)
حاکمیت داده شامل سیاستها، فرآیندها و استانداردهایی است که کیفیت، امنیت، حریم خصوصی و مطابقت دادهها با قوانین را تضمین میکند:
- کاتالوگ داده: مستندسازی متادیتا و سرچشمه دادهها
- کیفیت داده: اعمال قوانین اعتبارسنجی و نظارت بر کیفیت
- امنیت داده: کنترل دسترسی، رمزنگاری، و ممیزی
- چرخه حیات داده: مدیریت نگهداری و حذف دادهها
تکنیکهای پیشرفته یادگیری ماشین
یادگیری انتقالی
یادگیری انتقالی به ما امکان میدهد از مدلهای پیشآموزش دیده بر روی دادههای کلان استفاده کنیم و آنها را برای وظایف خاص تنظیم دقیق (Fine-tune) کنیم. این رویکرد زمان و منابع محاسباتی را به شکل چشمگیری کاهش میدهد.
یادگیری فدرال
یادگیری فدرال امکان آموزش مدلهای یادگیری ماشین بدون انتقال دادههای حساس به سرور مرکزی را فراهم میکند. این رویکرد برای حفظ حریم خصوصی بسیار مهم است.
یادگیری مستمر
یادگیری مستمر به مدلها اجازه میدهد تا از دادههای جدید یاد بگیرند بدون اینکه دانش قبلی خود را فراموش کنند، که برای محیطهای دینامیک با جریان مداوم داده ضروری است.
پیشبینی سری زمانی
برای تحلیل دادههای زمانی، تکنیکهای خاصی وجود دارند:
معماریهای پیشرفته یادگیری عمیق
شبکههای ترانسفورمر
مدلهای ترکیبی
بهینهسازی مدلها
تکنولوژیهای نوظهور و آینده دادههای کلان
محاسبات کوانتومی
کامپیوترهای کوانتومی میتوانند:
- الگوریتمهای بهینهسازی پیچیده را سریعتر حل کنند
- شبیهسازیهای مولکولی دقیقتری انجام دهند
- الگوریتمهای یادگیری ماشین را تسریع کنند
دوقلوهای دیجیتال
دوقلوهای دیجیتال نمایش مجازی از اشیا، فرآیندها یا سیستمهای فیزیکی هستند که با استفاده از دادههای کلان بهروزرسانی میشوند. این تکنولوژی در صنعت، ساختوساز و شهرسازی کاربردهای گسترده دارد.
متاورس و واقعیت مجازی
بلاکچین و دادههای کلان
رایانش عصبیشکل
تراشههای اختصاصی هوش مصنوعی
سیستمهای چند عاملی و عاملی
فریمورکهایی مانند:
امکان ساخت سیستمهای پیچیده چند عاملی برای تحلیل دادههای کلان را فراهم میکنند.
مدلهای زبانی بزرگ و دادههای کلان
مدلهای زبانی بزرگ نیازمند دادههای کلان برای آموزش هستند و در عین حال میتوانند برای تحلیل متنهای حجیم استفاده شوند:
مدلهای کوچک زبانی
مدلهای کوچک زبانی (SLM) رویکرد جدیدی هستند که با دادههای کمتر و منابع محاسباتی کمتر، عملکرد قابل قبولی ارائه میدهند و برای پردازش محلی مناسبتر هستند.
استراتژیهای عملی برای سازمانها
شروع کار با دادههای کلان
۱. تعریف اهداف کسبوکار
قبل از هر چیز، باید مشخص کنید که چه مسائل کسبوکاری میخواهید با دادههای کلان حل کنید. آیا میخواهید رضایت مشتری را افزایش دهید؟ هزینهها را کاهش دهید؟ درآمد را افزایش دهید؟
۲. ارزیابی آمادگی داده
بررسی کنید که چه دادههایی در دسترس دارید، کیفیت آنها چگونه است و چه شکافهایی وجود دارد.
۳. ایجاد زیرساخت مناسب
بسته به نیازها و بودجه، میتوانید از راهکارهای on-premise، cloud یا hybrid استفاده کنید.
۴. استخدام یا آموزش تیم
تیمی متشکل از دانشمندان داده، مهندسان داده، تحلیلگران و متخصصان کسبوکار نیاز دارید.
۵. شروع با پروژههای کوچک (POC)
به جای پروژههای بزرگ و پیچیده، با اثبات مفهومهای کوچک شروع کنید و موفقیتهای کوچک را جشن بگیرید.
۶. مقیاسدهی تدریجی
پس از موفقیت پروژههای آزمایشی، به تدریج آنها را مقیاس دهید و به فرآیندهای کسبوکار ادغام کنید.
ایجاد فرهنگ دادهمحور
موفقیت در دادههای کلان فقط مسئله تکنولوژی نیست، بلکه نیازمند تغییر فرهنگ سازمانی است:
- شفافیت داده: دسترسی آسان به دادهها برای تمام ذینفعان
- محو سواد داده: آموزش تمام کارکنان در مورد تفسیر و استفاده از داده
- تصمیمگیری مبتنی بر داده: ترغیب مدیران به استفاده از داده در تصمیمات
- آزمایش و یادگیری: ایجاد فضایی که شکست بخشی از فرآیند یادگیری باشد
آینده دادههای کلان: فرصتها و تهدیدها
هوش مصنوعی عمومی و فراهوش
مدلهای جهانی و شبیهسازی
مدلهای جهانی در هوش مصنوعی تلاش میکنند با تحلیل دادههای کلان، مدلهای جامعی از دنیای فیزیکی بسازند که بتوانند آینده را شبیهسازی کنند.
هوش مصنوعی خودبهبود
مدلهای هوش مصنوعی خودبهبود میتوانند با استفاده از دادههای تولیدی خودشان، بدون دخالت انسان بهبود یابند، که میتواند به رشد تصاعدی قابلیتها منجر شود.
کشف علمی خودکار
مدلهای استدلالی
مدلهای جدیدی مانند:
قابلیتهای استدلالی پیشرفتهتری دارند که برای تحلیل دادههای پیچیده ضروری است.
تهدیدهای احتمالی
فروپاشی اقتصادی
فروپاشی اقتصادی با هوش مصنوعی یکی از نگرانیهای جدی است. اتوماسیون گسترده ناشی از تحلیل دادههای کلان میتواند منجر به بیکاری گسترده و نابرابری اقتصادی شود.
تأثیرات منفی بر انسانها
سوءاستفاده از دادههای شخصی
از دستکاری افکار عمومی گرفته تا نظارت گسترده، سوءاستفادههای متعددی از دادههای کلان امکانپذیر است.
ابزارها و چارچوبهای عملی
کتابخانهها و فریمورکهای پایتون
پردازش و تحلیل داده
- NumPy: محاسبات عددی و آرایههای چندبعدی
- Pandas: دستکاری و تحلیل دادههای ساختاریافته
- Dask: پردازش موازی دادههای بزرگ
یادگیری ماشین و عمیق
- TensorFlow: فریمورک جامع یادگیری عمیق
- PyTorch: فریمورک محبوب محققان
- Keras: API سطح بالا برای یادگیری عمیق
- Scikit-learn: الگوریتمهای یادگیری ماشین کلاسیک
بینایی ماشین
- OpenCV: کتابخانه قدرتمند پردازش تصویر
- Pillow: پردازش تصویر ساده
مرئیسازی
- Matplotlib: مرئیسازی استاتیک
- Plotly: مرئیسازی تعاملی
- Seaborn: مرئیسازی آماری
پلتفرمهای توسعه
محیطهای ابری برای یادگیری عمیق
ابزارهای توسعه
- Jupyter Notebook: محیط تعاملی برای تحلیل داده
- VS Code: ویرایشگر کد قدرتمند
- Claude Code: دستیار هوشمند کدنویسی
معماریهای شبکه عصبی پیشرفته
شبکههای عصبی کانولوشنال
شبکههای عصبی بازگشتی
شبکههای عصبی گرافی
معماریهای نوآورانه
الگوریتمهای کلاسیک یادگیری ماشین
الگوریتمهای خوشهبندی
Random Forest
Random Forest یک الگوریتم قدرتمند برای طبقهبندی و رگرسیون است که بر پایه درختان تصمیم کار میکند.
Gradient Boosting
یادگیری نیمهنظارتی
کاربردهای خاص و نوظهور
تولید محتوا با هوش مصنوعی
تولید تصویر
تولید ویدئو
تولید بازی
تولید محتوای متنی
بهینهسازی تجربه کاربری
کاربردهای خاص صنعتی
استخدام و منابع انسانی
آموزش
خدمات دولتی
خانههای هوشمند
صنعت مد
بانکداری
ورزش
حقوقی و قضایی
روانشناسی و سلامت روان
مدیریت بحران
تبلیغات
مدلهای پیشرفته و مقایسهها
مقایسه مدلهای زبانی
ChatGPT vs Gemini
Gemini vs Claude
GPT-5 vs Claude 4.1
مقایسه مدلهای برنامهنویسی
مدلهای GAN و پخش
شبکههای متخاصم مولد
مدلهای پخش
مدلهای پخش رویکرد جدید و قدرتمندی برای تولید تصویر و ویدئو هستند.
مدلهای چندوجهی
چشمانداز آینده و فرصتهای کسبوکار
فرصتهای کارآفرینی
تحول در صنایع
آینده کار
هنر و خلاقیت
روباتیک
تعامل انسان و ماشین
رابط مغز-کامپیوتر
هوش مصنوعی احساسی
گفتگو با هوش مصنوعی
روابط احساسی
تکنولوژیهای پیشرفته
مرورگرهای هوشمند
موتورهای جستجوی پیشرفته
SEO با هوش مصنوعی
مدلهای اقدام بزرگ
مفاهیم پیشرفته
هوش جمعی
هوش جمعی از الهام از رفتار حیوانات اجتماعی، بهینهسازی پیچیده را امکانپذیر میکند.
RAG
هذیان هوش مصنوعی
آگاهی ماشینی
محدودیتهای درک زبان
روندهای جدید و نوآوریها
نتیجهگیری
دادههای کلان دیگر صرفاً یک واژه فنی نیست؛ بلکه به نیروی محرکه اصلی تحول دیجیتال در تمام جنبههای زندگی انسانی تبدیل شده است. از بهداشت و درمان گرفته تا مالی، از کشاورزی تا شهرسازی، از هنر تا علم، دادههای کلان در همه جا حضور دارند و نقش حیاتی ایفا میکنند.
با افزایش حجم، سرعت و تنوع دادهها، ابزارها و تکنولوژیهای جدیدی مانند Hadoop، Spark، NoSQL، یادگیری عمیق و محاسبات ابری توسعه یافتهاند که مدیریت و تحلیل این اقیانوس عظیم از اطلاعات را امکانپذیر میکنند.
اما دادههای کلان فقط فرصت نیستند؛ چالشهای جدی نیز با خود به همراه دارند. حفظ حریم خصوصی، امنیت داده، سوگیری الگوریتمی، کیفیت داده، و تمرکز قدرت همگی مسائلی هستند که باید با دقت مدیریت شوند. سازمانها باید با مسئولیت و شفافیت از دادههای کلان استفاده کنند و به اخلاق و اعتماد اهمیت دهند.
آینده دادههای کلان با پیشرفتهایی در هوش مصنوعی عمومی، محاسبات کوانتومی، Edge AI، دوقلوهای دیجیتال، و مدلهای زبانی پیشرفتهتر، بسیار روشن و هیجانانگیز است. این تکنولوژیها نه تنها کارایی و بهرهوری را افزایش میدهند، بلکه میتوانند مسائل پیچیده بشری از تغییرات اقلیمی تا بیماریهای صعبالعلاج را حل کنند.
برای موفقیت در این دنیای دادهمحور، سازمانها باید:
- فرهنگ دادهمحور ایجاد کنند
- در زیرساخت و ابزارهای مناسب سرمایهگذاری کنند
- تیمهای متخصص استخدام یا آموزش دهند
- حاکمیت داده را جدی بگیرند
- با چابکی و نوآوری به پیش بروند
در نهایت، ارزش واقعی دادههای کلان نه در حجم آنها، بلکه در توانایی ما برای استخراج بینشهای معنادار و تبدیل آنها به اقدامات عملی است. دادههای کلان ابزاری قدرتمند هستند که اگر به درستی استفاده شوند، میتوانند دنیایی بهتر، کارآمدتر، عادلانهتر و پایدارتر بسازند. اما این وظیفه ماست که با مسئولیت، شفافیت و توجه به ارزشهای انسانی از این قدرت استفاده کنیم.
سفر به دنیای دادههای کلان تازه شروع شده است، و هر روز امکانات و چالشهای جدیدی پیش روی ما قرار میگیرد. آنچه مسلم است این است که دادههای کلان نقشی کلیدی در شکلدهی به آینده بشریت خواهند داشت، و ما همگی بخشی از این تحول تاریخی هستیم.
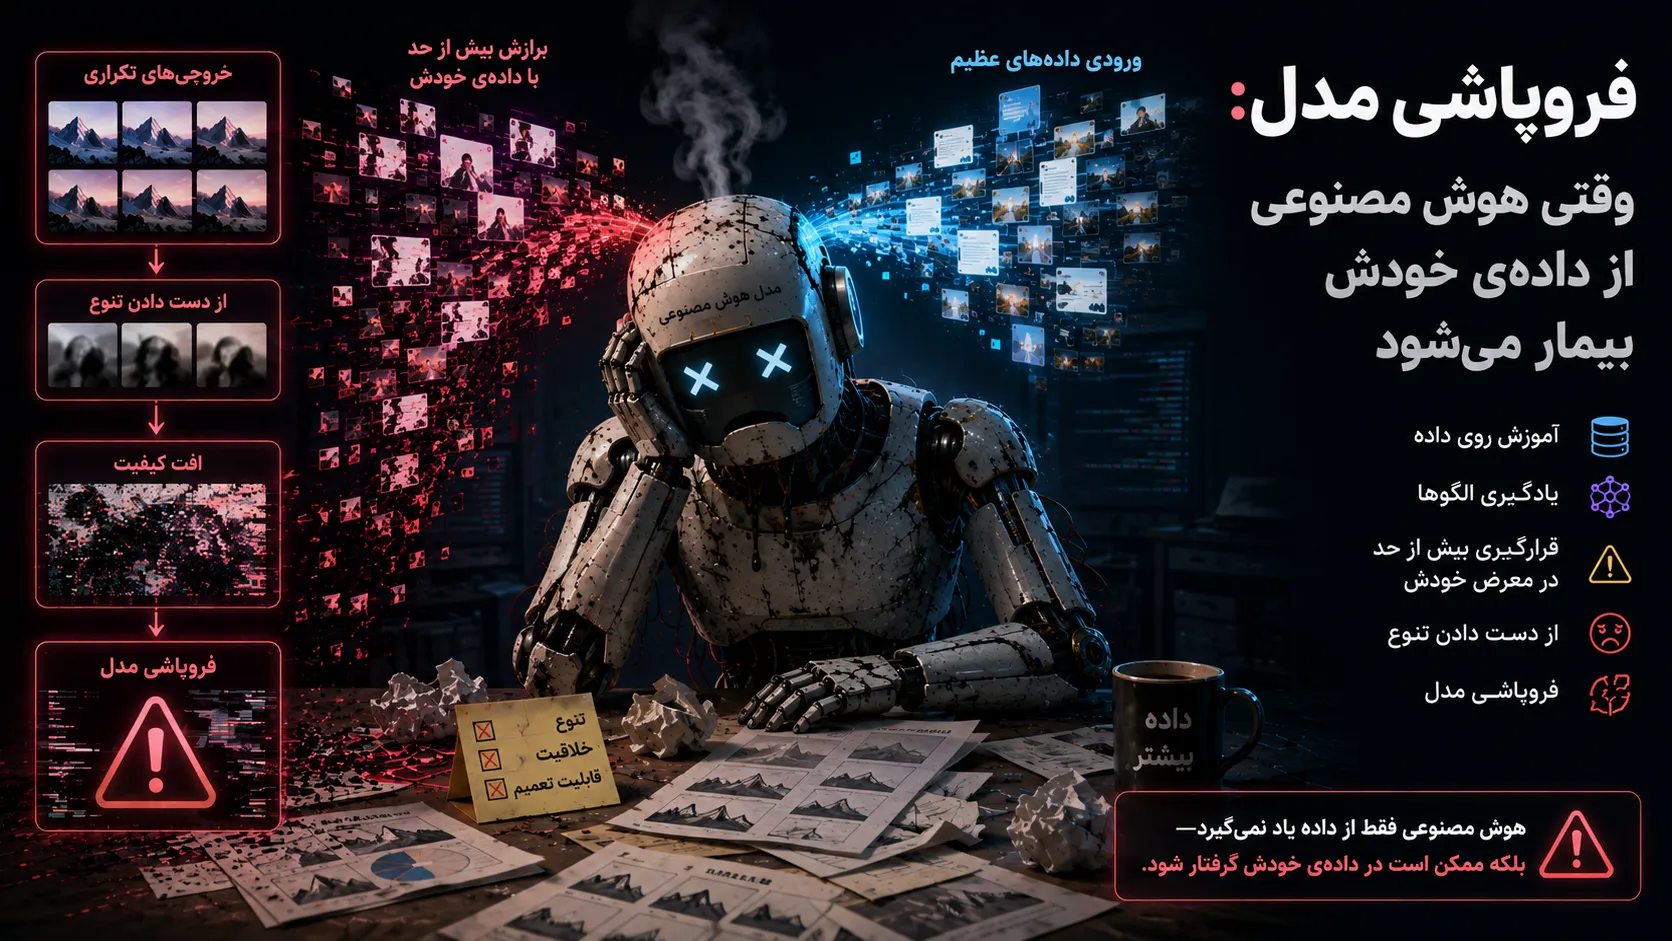 مبانی و الگوریتمهای هوش مصنوعی
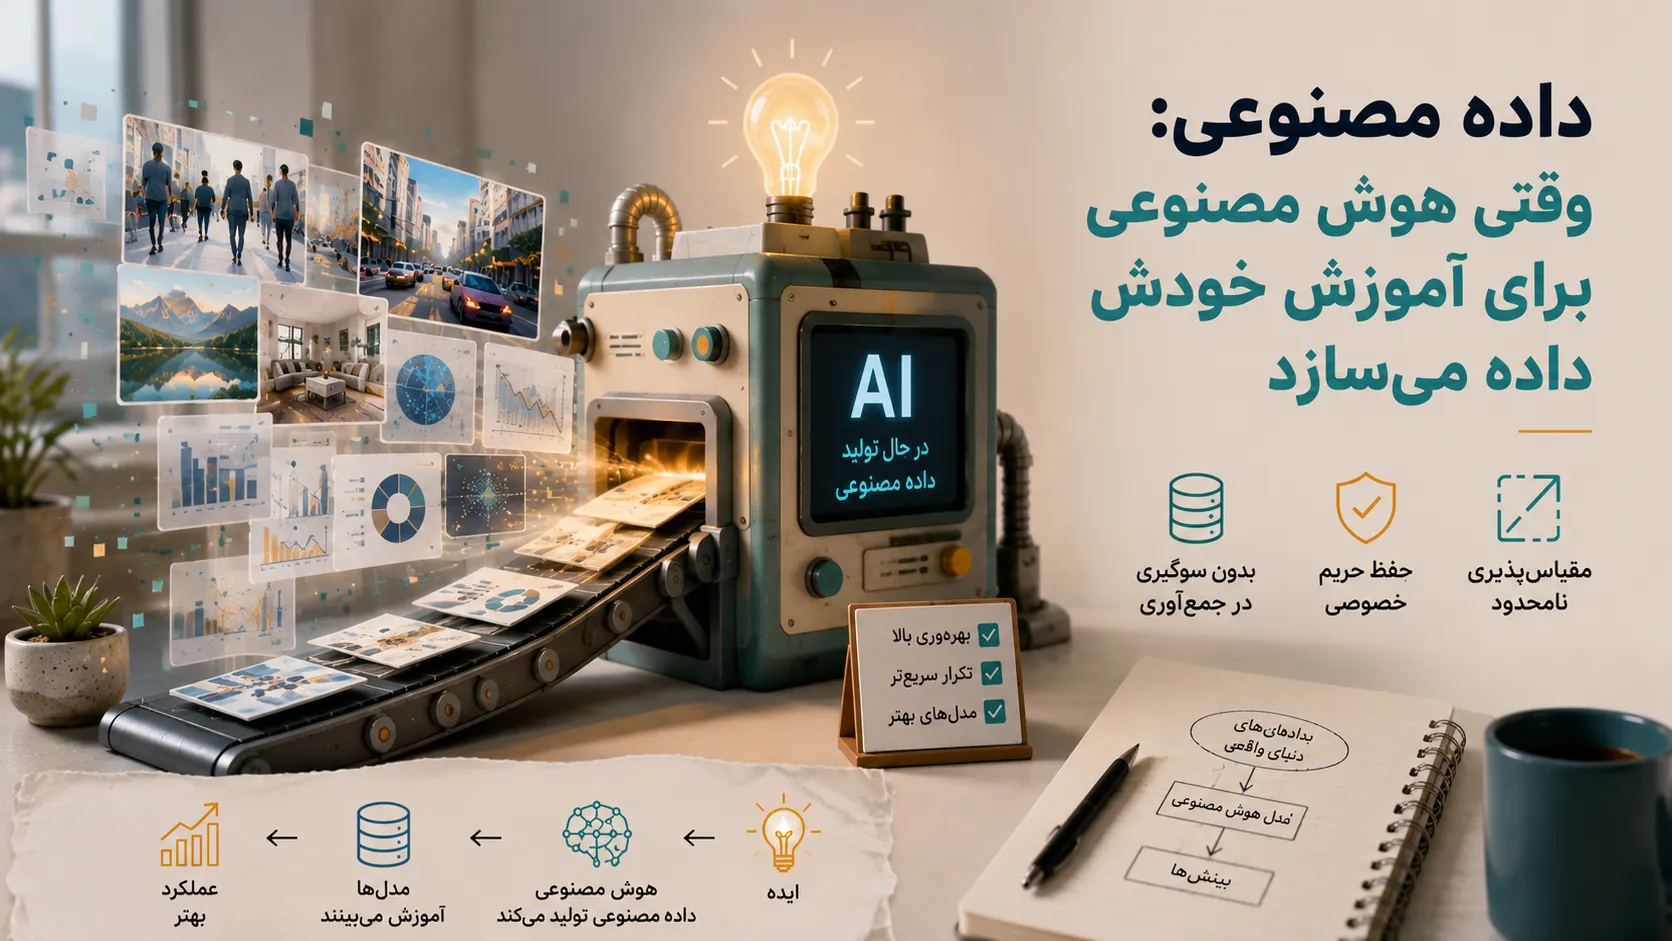 مبانی و الگوریتمهای هوش مصنوعی
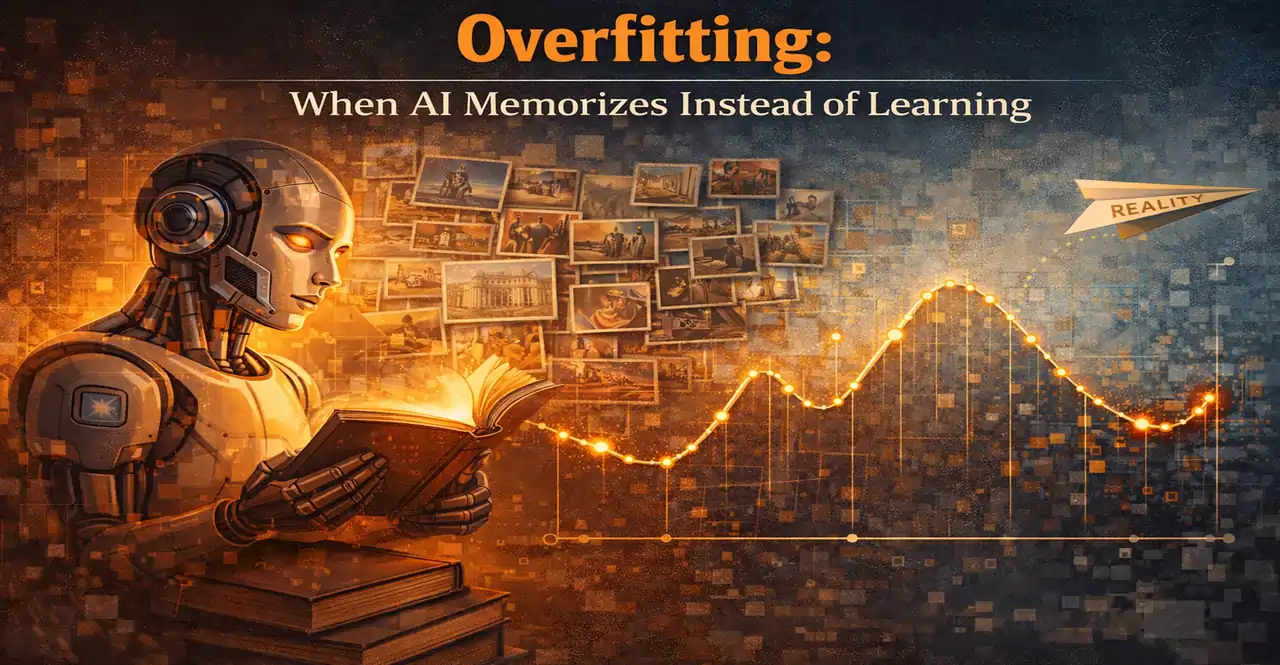 مبانی و الگوریتمهای هوش مصنوعی
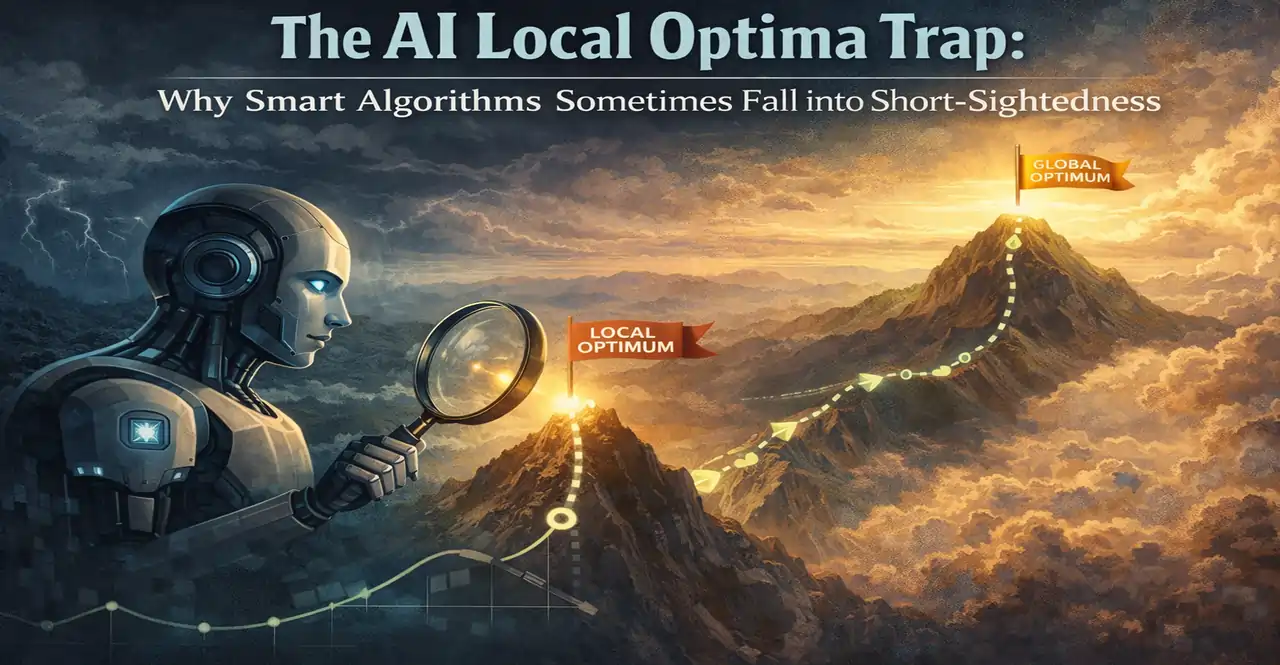 مبانی و الگوریتمهای هوش مصنوعی
 مبانی و الگوریتمهای هوش مصنوعی
 مبانی و الگوریتمهای هوش مصنوعی